諸事情あって、noteの方に引っ越そうと思います
引っ越し先 ↓
note.com
過去の記事は、何らかの形でまとめたりリメイクするなどして新たにnoteで公開しようと思っています
よろしければnoteの方もフォローしていただけると幸いですmm
諸事情あって、noteの方に引っ越そうと思います
引っ越し先 ↓
note.com
過去の記事は、何らかの形でまとめたりリメイクするなどして新たにnoteで公開しようと思っています
よろしければnoteの方もフォローしていただけると幸いですmm
「AIが進化・普及すると、データ分析の仕事はなくなるのか?」
データに関わる多くの人はこうした疑問をお持ちではないでしょうか。
ということで、AI(Gemini)に色々質問してみたので、それをブログにしてみようと思います
なお、ほとんどAIの文言のままなので、言い方や表現は大げさだったり、違和感ある部分もあるかもしれませんが、ご容赦下さいmm
まず、「どのような領域からAIの波を受けるのか」の整理から議論は始まった。
SQL抽出・定型レポーティング担当:
「〇〇のデータを抽出して」「ダッシュボードを作って」という指示を受けてSQLを書き、BIツールを構築するだけの業務。自然言語からSQLを自動生成するAI(Text-to-SQL)や自動可視化ツールの進化により、最もAIによる省力化が進む。
手作業中心のデータアナリスト、BI(ダッシュボード)構築専門エンジニア、レポーティング担当者などは、AIによる内製化やビジネス職が兼任することで今後大幅に減少していく可能性が高い。
一方で、世間では「分析やAI学習の土台となる『綺麗でスケーラブルなデータ基盤』を作るデータエンジニア(DE)の需要はむしろ高まる」と言われている。
AIが正しい分析をするためには、元となるデータが綺麗に整理・統合されている必要があり(Garbage in, Garbage out)、データエンジニアにはインフラやパイプラインを組む高度な開発力が必要なため、成り手が少なく希少価値が高い状態である
結果として今後は、「データエンジニア」の比率が高まり、「作業者レベルのデータアナリスト」の市場比率が小さくなっていく方向へシフトしていくと考えられる
しかし、データエンジニアと一括りに言っても、実態は「泥臭い配管工事をする作業者(パイプライン作成屋)」から「事業全体のデータ構造とAI基盤を設計する最高建築士(データアーキテクト)」まで、ピンキリである
前述の通り手作業中心のデータアナリストがAIに代替されるのと同様に、「ただの作業者(指示通りにパイプラインを組むだけのデータエンジニア)」もまた、AI(CursorやCopilot、Auto-ETLツール)に代替されるリスクが非常に高い
「上級データアーキテクト(DA)のような全社設計を担う専門職は、AIに代替されない職種なのか?」
この疑問を検証するため、DAと他の職種(システムアーキテクト、インフラエンジニア、データアナリスト/アナリティクスエンジニア)との境界線を整理した。すると、「独立した職種としての立ち位置」よりも「他職種との領域の重複」が浮き彫りになってきた。
「どのデータを、何の目的で、どういう粒度(日次・顧客単位など)で集めるか」というデータの取捨選択やロジック設計は、活用側(アナリストやAE、プロダクトマネージャー)の領分である。
分析基盤のデータを別システムやプロダクトにリアルタイム還元(リバースETL等)させる設計で求められるのは、レイテンシや障害耐性の担保である。これは既存のシステムアーキテクト(SA)やバックエンドエンジニアが得意とする領域そのものである。
クラウド(AWS/GCP/Snowflake等)上のセキュリティやコスト最適化などは、インフラエンジニア(SRE/DevOps)の領域と重なる。
超大規模プラットフォームや高度な法規制対応を迫られる企業でない限り、「データアーキテクト」という単体職種を置くケースは限定的になる。多くの企業では、活用側が意味を決め、SAやSREがインフラを組む「兼任・協働アプローチ」が現実解となっていく。
現場のリアリティとして、現在の社内データは「型がバラバラ」「ドキュメントがない」「レガシーシステムとの接続」など、カオスそのものである。そのため、短期的にはエンジニアによる泥臭いデータ洗浄や配管作業が不可欠であることは言うまでもない。
しかし、中長期的な技術の潮流を見渡すと、海外のデータ業界やAIスタートアップ、研究機関において「データ基盤自動化Agent(AI Agent for Data Pipelines)」の開発と実用化が加速している。
これまで手作業で行われていたスクリプト記述やエラーハンドリングを、AI Agentが自律的に肩代わりする世界へとシフトしつつあるのだ。
単なる「コード補完(Copilot)」を超えて、データパイプラインの監視・修正・構築を自律的に行うAI Agent(Agentic Data Engineering)の導入が始まっている。
dbt Labsや海外の技術検証プロダクトでは、dbtやDatabricksのテスト失敗ログをAI Agentが読み取り、自動でコードのバグ原因を特定して修正のPull Requestを出す「セルフヒーリング(自己修復機能)」が実現し始めている。
ソースDBのカラム名変更や追加によってパイプラインが壊れた際、Agentがリアルタイムで検知し、後続の変換処理コードを自動書き換えしてエラーを回避する手法が注目を集めている。
Integrate.ioなどの最新データ統合ツールでは、MCPサーバーを介してClaudeやCursorといったAIアシスタントが直接データ基盤にアクセスし、自然言語の指示からパイプラインの作成・実行・テストまでを一気通貫で行える環境が整いつつある。
パイプラインの配管作業だけでなく、ソースデータから活用用のデータマートへと繋ぐ「中間データモデル(いわゆるSilver層 / 共通正規化層)」の設計・構築も、AI Agentが主導する領域へとシフトしていく。
ソースの生のデータ(RDBのレプリカやログ等)を直接AIに参照させるのは、トークンコストの膨大化やハルシネーション、パフォーマンス悪化の観点から現実的ではない。そのため、中間データ層の存在自体は今後も不可欠だ。
しかし、「スキーマの読み込み、重複排除、型の整形、汎用的な粒度への結合」といった標準的な中間テーブルの作成作業は、AI Agentが最も得意とする領域である。
ここで人間に残るコアな役割は、物理的な中間テーブルのSQLを書くことではなく、「ビジネス上の定義(セマンティックレイヤー)」を記述・管理することに集約される。
「1顧客の定義とは何か」「売上が確定するロジックは何か」を人間(AEやアナリスト)が厳密に定義しておけば、AI Agentはその定義を参照し、中間モデルの生成から必要なデータマートの動的作成・クエリ最適化までを裏側で自動処理するようになる。
つまり、「データエンジニアが時間をかけて中間データモデルを手動で設計・構築する時代」は終わり、人間が「データに意味づけ(セマンティック定義)を行い、AI Agentに中間加工とマート生成を指示・管理させる時代」へと移行するのだ。
こうしたAI Agentテクノロジーが実用化・標準化していけば、エンジニアに頼らざるを得なかった「泥臭い配管作業や障害対応」のハードルは劇的に下がる。
結果として、「ドメイン知識(事業理解)」と「データの意味付け」を持つアナリストやアナリティクスエンジニア(AE)が、AI Agentを高度なアシスタントとして従え、自力でデータ管理から活用までを一気通貫で回せる範囲が広がっていくこととなる。
ここでさらに一歩踏み込んだ問いが生まれる。
ではデータエンジニアさえも不要になっていくのか?
そもそもデータアナリストやAEもAIに代替される恐れがあるのではなかったか?
そうなるとこれまで各データ職種が担ってきた専門的な役割は、AIによって他の職種でもカバー可能になり、データ専門職自体不要になるのか?
いや、そうはならないだろう
パイプライン構築や中間データモデル(Silver層)の自動生成までAI Agentが担うようになると、データ業界に長年続いていた「職種の細分化」に大きな変化が訪れる。
そもそも、データエンジニア(DE)、アナリティクスエンジニア(AE)、データアナリスト(DA)といった職種が細かく分断されていた最大理由は、「それぞれの領域で手作業による構築・コード記述・ダッシュボード作成の工数が多すぎたから」に他ならない。
AI Agentによって手作業のボトルネックが解消されると、1人の人間がカバーできる物理的な作業範囲は従来の数倍に跳ね上がる。結果として、分業に伴うコミュニケーションコストの方が高くなり、過剰に分かれすぎていた職種境界は溶け、役割の「再統合」が進んでいく。
種々の作業(Do)がAIに代替されたとき、人間(データ専門職)に求められる領域は「データ整備作業」や「分析作業」から「意思決定の支援」へとシフトする。
AIは「事業Aから撤退すべき(成功確率88%)」という最適な予測を出せるが、撤退に伴うリスクを受け止め、判断を下すのは人間である。アナリストの役割は、単なる数値出力ではなく「意思決定者が納得して腹を括れるだけの十分な検証と裏付け」を提供することだ。
意思決定者が直接AIを使うと、自分の仮説に都合が良いデータばかりを抽出させる「確証バイアス」に陥りやすい。「AIの提示した分析には、こういうデータの偏り(リスク)があります」と、データの専門知をもって冷静に指摘できるブレーキ役が必要とされる。
DE・AE・DAの役割の統廃合が進んでいくと、一人でより多くの役割をこなせる人の価値が高まっていく。
そうなると「AIを使いこなしてデータ基盤〜分析まで一人で完結させるプレイヤー」や「低単価作業者/AIを束ねるマネージャー」という実務側の生き残りルートが明確に浮かび上がってくる
AI Agentを「超優秀な手足」として従え、データ基盤の整備・セマンティック定義・分析・レポーティングまでを1人で一気通貫で全回しするプレイヤー。
価値: 従来の3〜5人分の成果を1人で出す圧倒的な開発スピードと低コスト。
大量のAI Agentや低単価の作業者(オフショア等)を指示・統制し、データの品質・ガバナンス・コストを監査・管理する司令塔。
価値: AIのハルシネーション検出、セキュリティ事故の防止、クラウドコスト爆発の制御などのリスク管理(Human-in-the-Loop)。
AIが出した分析結果を徹底的に疑い・叩き、経営陣や事業部長が「リスクを取って腹を括るための納得感」を作る最高参謀。
価値: 確証バイアスの防止、データに表れない政治・人間関係(ドメイン文脈)の理解、決断へのアラインメント。
※このほか、ペタバイト級データを扱う超高度なコア基盤エンジニアや、医療・創薬など極度のドメイン専門数理モデルを扱う研究者など、「1%の超高度専門職」も残る。
今回の議論を通じて見えてきたのは、データ職種の「消滅」という単純な危機論ではなく、「手作業時代(細分化)の終わりと、職種の再統合」である。
「SQLが書ける」「パイプラインが組める」「ダッシュボードが作れる」といった単一の作業スキルは、AI Agentの登場によって急速にコモディティ化していく。
だからこそ、私たちは自問しなければならない。
AIを使い倒して「1人で全回しするフルスタック」を目指すのか?
AIと作業者を束ねて「リスクとガバナンスを管理する司令塔」を目指すのか?
AIと深く議論し「意思決定者の腹を括らせる軍師」を目指すのか?
「フルスタック」「司令塔」「軍師」——そう聞くと、「元々マルチスキルな天才しか生き残れないのではないか」「1つの職種経験しかない自分にはハードルが高すぎるのではないか」と感じるかもしれない。
しかし、最初からオールマイティだった人間など存在しない。
単一の職種経験(例えば「SQL集計しか経験がないアナリスト」や「パイプライン構築しか経験がないDE」)からスタートし、AI時代に生き残れる人となれない人の差を生むのは、現在の技術力ではなく「思考と行動の転換」ができるかどうかだ
AI Agentという強力なアシスタントが登場したことの本当の意味は、単なる業務効率化ではない。「専門外の領域へ足を踏み入れる技術的ハードルが、劇的に下がった」ということだ。
「自分はデータエンジニアだから」「自分はアナリストだから」という過去の職種の壁に留まり、AIに作業を奪われるのを待つのか。
それとも、AIという補助輪を使って自らの境界線を押し広げ、AIを従える側に立つのか。
そのマインドセットの転換こそが、AI時代における唯一にして最大の生き残り戦略になるはずだ。
最後まで読んでいただきありがとうございます
ブログ作者は「3つどれも面白そうでやりがいありそう」に感じましたが、これが結論でおしまいというわけではなく、その他の方向性もあるかもしれない/あるいは新たに出てくるかもしれないとも思うので、引き続き柔軟にキャリアについて思い悩み続けていこうと思ってます
スタートアップ企業でデータ分析・データ活用を担当して数年が経ちました。
毎日SQLを叩き、ダッシュボードを作り、生成AIにデータを食わせては「これ本当に意味あるんか?」と自問自答する日々です。
以前に書いた記事「データ分析とデータ活用の違い」でも触れましたが、最近の自分のツイートや仕事を通じてもう一度整理すると、データ分析は手段であって、データ活用こそが目的だということが、ますます鮮明になってきます。
1. 「データ分析」だけでは足りない。現場が欲しているのは「活用できる形」
よくある誤解として、「データを見ればいろいろ分かるはず」というものがあります。
実際には、世の中には間違ったデータ分析が溢れていて、むしろ意思決定を混乱させるケースも少なくありません。
私がスタートアップで感じるのは、ビジネスサイドの人たちが本当に欲しいのは「この課題をどう解決すればいいか、データで裏付けられた次のアクション」です。
だからこそ、データ人材に期待される役割は、仮説立案や課題発見そのものより、仮説を検証し、課題を具体化・構造化・定量化して、チームが動きやすい形にすることだと最近強く思っています。
「ローデータちょうだい」と言っていた人が、今では「分析基盤の全データを学習させた生成AIちょうだい」と言ってくるようになりました。
でも、課題分析や仮説構築がしっかりできていないと、ろくなプロンプトは書けませんし、AIが出した回答の精度も判断できません。
結局、AIを使っても人間の思考力と業務理解がボトルネックになっているのが実情です。
2. データ専門家の本当の役割は「仕組み」と「文化」を作ること
「データ分析の専門家はいらない」という極論をたまに聞きますが、それは現場がデータに基づいた意思決定を自律的にできるようになった未来の話です。
そこに至るまでの道のりで、私たちデータ担当者がやるべきことは以下の2つだと考えています。
特にMixpanelが提唱する「虚栄の指標を見抜く4つのテスト」は、今でも非常に参考になります。
数字を見せられて「チームを安心させるため」の指標に惑わされず、本当にビジネスを動かす指標にフォーカスする意識が重要です。
3. 生成AI時代にますます問われる「人間力」
AIの進化は本当にすごくて、同じ作業にかかる時間は確実に減っています。
ただ、時間短縮分は「さらに品質を上げること」や「別の価値ある仕事」に回っているので、労働時間が劇的に減った実感はまだありません(笑)。
過去の自分のブログ記事を全部AIに読み込ませて質問してみたのですが、回答は「自分っぽい部分」と「なんか違う部分」が混在していました。
もっと記事を増やして学習させないと、自分自身を代替できるレベルにはならないな、と感じています。
将来的には、自分の思考パターンを学習させたAIを「引き継ぎ用」や「不在時の対応用」として使えたら面白いな、とひそかに企んでいます(月数千円くらいで…)。
AIがプロセスにどんどん入り込んでくる中で、最後に問われるのはやはり人間力です。
業務課題への理解、適切な仮説構築、AIの出力に対する批判的思考、そして何より「このデータから何を読み取り、チームにどう伝えるか」というコミュニケーション力。データサイエンティストという「最もセクシーな職業」と言われたブームは去りましたが、データに基づく意思決定は必須の役割として残り続けています。
4. これからデータ人材を目指す人へ
もしこれからデータ分析の仕事を始めようとしている人、特にジュニアクラスの方へ。SQLやツールのスキルは大事ですが、それ以上に志向性・業務貢献意識・性格の相性が重要になります。
向いている人はすぐ上達しますが、向いていない人はとことん苦戦する分野でもあります。
まずは「業務課題をデータで解決する」というマインドを最優先に。
そして何より、勉強ばかりでノウハウコレクターにならないこと。
昔から言っていることですが、やる気のある若手ほど陥りがちです。
実際にステークホルダーやチームにに対して少しでも何らかの価値を提供しようとする経験を積む方が、ずっと成長が早いです。
最後に
スタートアップという変化の激しい環境でデータに向き合い続けていると、「データ分析の専門家」から「データ活用を推進するファシリテーター」へと役割が変わっていくのを感じます。
現場がデータを見て自ら判断し、動けるようになる。
そのための仕組みと文化を残していくこと。それが今の私のミッションだと思っています。
ブログも少しさぼり気味でしたが、またコツコツ更新していきます。
データ活用に取り組む皆さんと、情報交換できたら嬉しいです。
上記の記事はこれまでの私のXでのツイートを元に、AI(Grok)で作成させたものです(データ活用をテーマにブログ記事作成して、と指示)
ツイート内容を上手くつなぎ合わせたり、つぶやき同士の間を補完するなどして結構短時間で記事として作成してくれました
どことなく少し不自然なところもありますが、なかなかの完成度ではないかと思います
私自身はプロンプトの指示とアウトプットをはてなブログ用に整形しただけなので、10分程度しか時間をかけていません
いちから作成する際は数時間かけてたので、ここまで短縮できるようになるのは驚きです
さらに数年したらAIはどんな感じに進化しているのでしょうか
私自身もあっと驚くような、気づきになるような記事を作ってくれたりするのでしょうか
楽しみです
データ分析をした後に、特に何もせずにやりっぱなしになっていないでしょうか。
もしそうであるならば、その分析結果が正しかったのか、間違っていたのか、役に立たなかったのか、そもそも必要だったのか、といった評価を下すことはできているでしょうか。
効果の見えにくいデータ分析の仕事を繰り返していると、適切なフィードバックも得られず、スキルが停滞してしまう恐れもあります。
とりあえずXX分析を実施してまとめて報告した、だけを繰り返しても成果を出すのはなかなか厳しいと思われます。
一度分析して終わりではなく、その後その結果をもとに実際にアクションが実行されているのかどうか、それを定量的に可視化できないか、とか
どのようなアクションがとられて、その結果はどうだったのか効果はどれくらいだったのか、とか
少なくともデータ分析結果の実証や分析後のアクションの管理までやってみることをお勧めします。
ABC分析を例にして考えてみましょう。
ちなみにABC分析とは、売上金額の高い順に商品を並べ、累積構成比に応じてA、B、Cの3つのグループに分類するというものです。
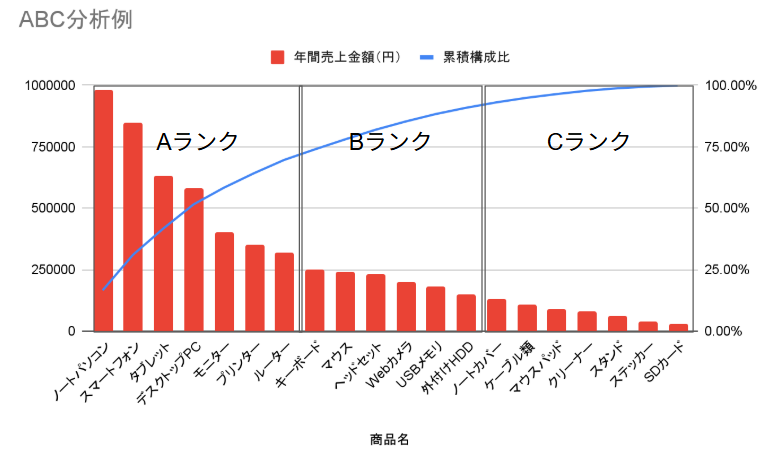
ABC分析によって、売上貢献の高いAランクの商品群が明らかになります。
データ分析者はこういった分析レポートを作成して実務担当者に報告するといった仕事をされていると思います。
ABC分析の場合、そもそも何のために行うのかというと「在庫管理」や「販売戦略」に活かすという目的が一般的には多いかと思います。
在庫管理で言えば、Aランク商品は常に在庫を切らさないように管理し、Bランク商品は必要に応じて、Cランク商品は在庫リスクの低い管理を行うといった感じです。
販売戦略の場合は、Aランク商品は重点的に販売促進を行い、Bランク商品は現状維持、Cランク商品は取り扱いを見直すなどの販売戦略を立てます。
データ分析は目的ありきなので、ABC分析のレポート作成の依頼を受ける際、こうした情報は事前に確認されているかもしれません。
しかし、上記のような在庫管理や販売戦略を実現するにはABCレポートだけで十分でしょうか?
確かにそもそもABCのランク分けをしないと始まらないので、最初にABCレポートを作成することは必要かもしれません。
しかしその後、Aランク商品を在庫を切らさないように管理するのであれば、在庫状況の可視化や在庫切れが発生した際の要因分析なども必要になりはしないでしょうか?
在庫切れしそうになっていないかを検知するアラート通知の仕組みもあったりすると良いかもしれませんね。
Aランク商品を重点的に販売促進するのであれば、本当にその後の販売施策でAランク商品の販売が伸びているか確認しなくても良いでしょうか?
そもそもどういった施策を計画しているのか、過去施策の分析やPoCなどを実施して効果の検証などを行わなくても大丈夫でしょうか。
データ活用というのは一度きりで終わるものではなく、継続的に実施するものです。
データ活用を意識してデータ分析を行うのであれば、レポートにまとめて報告して終わり、ではなく次に必要な分析やデータは何かを考え続けていくことが大事です。
それを繰り返すことで、データ活用を阻害するポイントや原因はどこか、データ活用を促進するために何をすれば良いか、なども見えてくるようになると思います。
依頼された単発のデータ分析をこなすだけでなく、ある程度のロードマップを最初に描いて依頼者と中長期的な関わりを提案してみるのもお勧めです。
自らフィードバックを得ようとしたり、PDCAにつながるような形に持っていこうとすると成長機会も多く得られるのではないかと思います。
KPIの「設計方法」は巷にたくさん情報がころがっていると思います。
基本的には以下のポイントにまとめられると思います
そもそも自分たちで改善できない指標であれば意味がないので、基本的にコントロール可能な指標である必要があります。
外部要因の影響を強く受ける指標であれば、当人たちがいくら頑張ってもその外部要因次第になってしまうので、運否天賦のようになってしまい、KPIマネジメントとは別物になってしまいます。
また改善可能な指標であっても、KGIと因果関係が全然なければ、改善したところであまり意味がないことになります。
いくらKPIを達成したところで、肝心のKGIが達成されないのであればあまり評価もされないでしょう。
なので、KGIにそれなりの影響のある指標であることも必要です。
KPIを考える際、色々な数値を見たいということで非常にたくさんの指標がリストアップされることがあります。
そうすると上記で述べた不適切な指標も混ざりやすくなりますし、データを準備する側・報告する側・管理する側みなの負荷も高まり、ひとつひとつの指標の重要性や意義が薄まってしまいます。
結果として、指標が多くなればなるほど管理しきれなくなり、やがてそのうちほとんどチェックされなくなります。
また基準値を決めづらいKPIも運用に堪えられなくなります。
例えば、売上 = 顧客数 × 顧客単価 の図式から
KPIとして、顧客数1万人、顧客単価1万円と設定したとします
両方達成すると1億円の売上となりますが、KGIが1億円ならば別に顧客数5千人、顧客単価2万円でも良いわけです。
逆に顧客単価が5000円に落ち込んでいるなら、KGI達成のためには2万人の顧客数が必要になります。
なので、顧客数だけを見ても現状の進捗および次にどうすべきかの判断は困難ではないでしょうか。
結局はKGIである売上だけが着目され、このような指標はただ参考値として見るだけになってしまうでしょう。
上記で述べた内容に気を付ければ、KPIマネジメントはうまく進められるのでしょうか。
自分のこれまでの経験上、おそらくもう少し気を付けるべきポイントがあるかと思うので、それについて紹介してみたいと思います。
まずは、運用管理の体制をきちんと整えることが必要かと思います。
本来はKPI設計を行った後で、各KPIとそれを管理する部署を考慮して、組織の組成をするというのがより理想かと思います。
しかし、色々な事情でそうなっていない場合、部署や個人ごとの業務範囲や目標(評価項目)はそれぞれの観点で設定されてしまうと思いますので、KPIの観点からするとちぐはぐなものになってしまったり、全体最適でないものになってしまいやすくなります。
とはいえ、いきなりそれらを変えることも難しいでしょうから、まずは各KPIごとにその運用管理に関わるべき部署や担当を明確にしてみることから必要でしょう。(部署横断のバーチャルなチームにするのも良いと思います)
自分の仕事はこのKPIに関連するものだけれど、特に目標を持たされてなかったり管理指示を受けてなかったりすると、自分事にするのは難しいものかと思います。
また、管理範囲は管理できない範囲で分けないように注意してください。
例えば、売上 = 顧客数 × 顧客単価 の図式から
顧客数を管理するチームと、顧客単価を管理するチームに分けたりすると、前者のチームはとにかく顧客数を増やすのがミッションなので、顧客単価が低かろうと気にしなくてよいことになり、後者のチームの足を引っ張ることにもなりかねません。
なので、この場合もし分けるならば顧客の種別ごとなどの方が良いかと思います(業界別、チャネル別、規模別など)
KPIごとに運用管理範囲が明確になっても、その中でKPI管理をリードする責任者がいないと運用管理がうまく回りません。
KPIをモニタリングできるダッシュボードが用意され、あとはメンバーそれぞれが見たいときに見るだけであれば、はたして共通の目標として運用されるでしょうか
きちんとチェックして改善に活かす人はそうするかもしれませんが、気が向いたときに見るだけという人もいるかもしれません。
KPI管理が「人による」という属人的なものになってしまいます。
そうならないよう責任者を設置し、改善のための活動を先導してもらう必要があります。
できれば責任者にはKPI管理の業務を評価にきちんと連動させ、改善する際にそのためのアクションを推進できる権限を持たせる必要もあるでしょう。
管理者が決まればあとはその人に丸投げしても良いでしょうか。
チームマネジメントにおいても定期的に進捗確認や1on1などを実施されると思いますので、同様にステークホルダーが集まって進捗確認・相談する場があった方が、属人的な管理を予防し、客観性を踏まえた管理になりやすくなります。
なんだ当たり前じゃないかと思われるかもしれませんが、そうした場を設けずにKPI運用されているケースも結構あるようです。
普段の定例会議などの場で確認するのはKGIだけで、KGIが悪化しているなどの事情があれば、そのときに参考資料としてKPI(の一部)を見るくらい、などはよくあるようです。
こちらはKPIの設計にも関連しますが、KPIがコントロール可能な指標ならば、どのようにコントロールすべきかも明白なはずです。
そうなるとKPIをもとにアクションプランが立てられることになるので、KPIが悪化した際に何が原因なのか、どうすれば改善できるのかも明確になります。
報告の場でKPIが悪化していることが明らかになった際、このあと原因を調べますで終わると対応が遅くなり、結局何もできなかったなんてこともよくある話です。
少し難しいのは、悪化要因がリソース不足のケースですね。
イレギュラーな事情により、KPIを改善するためのリソース(人、物、金、時間)が不足してしまった場合、リカバリーするのは容易ではないかもしれません。
もし下方修正が必要になりそうでも、早めにステークホルダーに連携すれば、他のKPIでカバーできたりリソース追加してもらえるかもしれないので、その根拠をきちんと示せるようにしておくのは大切でしょう。
いきなり最初から最適なKPIを決めて運用管理できるようになるかというとなかなか厳しいかと思います。
事前に最適な設計を行おうとしても時間や労力をかけても、やってみないとわからないとか運用してはじめて気が付くこともあったりするものです。
そのためまずはトライアル運用してみることがおすすめです。
トライアルという位置づけならば、改善の意見も出しやすくなりますし、途中で軌道修正の対応もしやすくなります。
本運用では既に運用が始まっているので途中で軌道修正しようにも困難だったりすることが多いようです。
また本運用だとその年度の運用管理が終了してすぐまた翌年度の運用が始まるということになり、振り返りや反省・改善がなされないままになることもよくあります。
結果的に同じ失敗を繰り返したり、KPIマネジメントを途中であきらめてしまうケースもよく聞く話です。
KPIの運用管理方法について、私のこれまでの経験を振り返ってみてとりあえず思いついたものを書き連ねてみました。
当然これで全てではないでしょうし、また気づいたことがあれば記事にするかもしれません。
KPの運用管理は「これが正解!」といった事例があまり世の中に出回らないので、結構いい加減な内容のものもよく聞きます。
上手くいかない場合は、設計に問題があるケースも多いと思いますが、実は運用管理もきちんと考慮されていないと、設計時の問題に気づけず同じミスを繰り返してしまうといったことも多いのではないかと思います。
つまり、PDCAが回るようになっておらず、延々とPDまたはPDCを繰り返しているようなイメージですね。
数年前からXXOpsという言葉をあちこちで聞くようになりましたが、オペレーション(運用)まで含めて考えることが重視されるようになった表れなのではないでしょうか。
従業員の仕事内容や給与を決めるのにグレード(等級)制度を使っている企業は多いと思います。
私が勤めている会社もグレードが導入されています。
先日人事制度の大きな見直しがなされることになり、合わせて同時にグレードの基準にも見直しが入ることになりました。
その中で私もデータアナリストの職種に関するグレードの設計を担当しました。
といったことがあったので、改めてデータアナリストのキャリア(社内)を今回のトピックに選んでみました。
そもそもグレードの高低はどのように決めるべきなのでしょうか?
一般的なキャリアアップの観点では、「スキルレベル」がよく話題に上がると思います。
例えばデータサイエンティストならばデータサイエンティスト協会というところがスキルレベルの定義をしていますね。
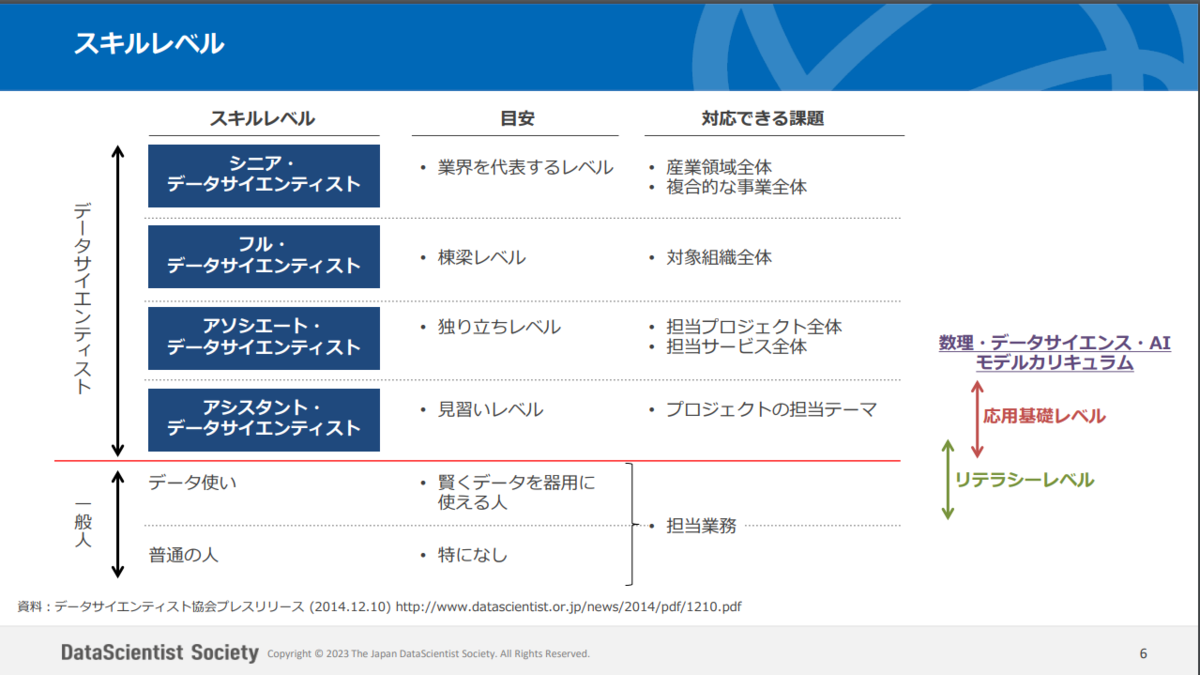
https://www.datascientist.or.jp/common/docs/10thsymp_skill.pdf
上記スライドは概要ですが、実際は各レベルごとにビジネス力・データサイエンス力・データエンジニアリング力の観点で細かくチェック項目が用意されています。
(チェックリストの細かい内容が気になる方はこちらまで)
ただ、企業内の人事評価と紐づくグレードでは、上記で言えば「ビジネス力」が特に強く影響されることが多いかと思います。
ニッチなスキルや専門知識をどれだけ持っているかなどは関係なくて、基本的にはあくまで「実績ベース」です。
そして上記のスライドでも記載されている通り、対応できる課題の事業規模の大きさのようなイメージなどで実績が測られます。
少々乱暴に言えば、シニアとジュニアの違いというのは、知識や経験の多寡ではなく、できることの規模や影響の大きさです。
もちろん大きな影響のある仕事を行うにはスキルや知識なども必要になりますが、あくまでそれらは「手段に過ぎない」ので、それらがあるから評価が上がるといった評価軸ではないということです。
逆に言えば、当たり前ですが知識や技術の単なるコレクターはあまり評価されず、それらを活かして成果を出せる人が評価されるということですね。
データサイエンティストのスライドを例にしてみます。
プロジェクトの中のいちテーマの仕事をやり遂げることができれば、アシスタントとして評価されます。
担当プロジェクト全体をゴールに導くことができれば、アソシエイトとして評価されます。
フル・データサイエンティストならば、対象組織全体の課題を解決できることが求められます。
「対象組織全体の課題の解決」というとちょっと抽象的でわかりにくいですが、以下のチェックリストの項目(一部抜粋)は参考になるでしょう。
・初見の事業領域に向かい合う場合や、スコープが複数の事業にまた がる場合であっても本質的な課題を見出し、構造化・深掘りができる
・入り組んだステークホルダー構造の中で、Win-Winの形で価値を設計・創造し、そこからの発展を見据えた仕込みと推進するハブとしての役割を担うことができる
・プロフェッショナルからなる複数のチームによるプロジェクトの役割、目標を定義、リスクをマネージしつつ推進し、全体としてのアウトプットにコミットできると共に、メンバーを育成、さらには持続的な育成システムを作り出すことができる
フル(シニア)クラスだと、そもそも上記のような仕事を任されないと評価の土台に上がらないですし、上記の仕事をやり遂げるには総合的かつタフなビジネススキルが必要になります。
データ活用で実績を積む場合、データを分析して何らかの示唆を出す程度では、全体の中のごく一部の作業を担っただけでしかないので、あまり大した実績とはみなされないでしょう。
独り立ちとされるアソシエイトのレベルでも、担当プロジェクト全体をやり遂げることが求められます。
つまり、プロジェクトの企画・提案から管理・遂行まで対応できることが必要です。
私が今まで見てきたメンバーの様子では、そもそもきちんとした企画を立てるところが結構ハードルが高いようです。
課題をヒアリングするだけで終わらず、その課題の本質的な原因を構造的に捉え、解決のために「具体的に」何をどうすれば良いのか、現実的かつ説得力のあるプランを作れる、
あるいは自ら事業的に効果/意味のあるゴール設定を行い、そのために必要なタスクの分解・要件定義をロジカルに作成できる人、などはあまり多くないように思います。
さらにステークホルダー(関わる部署/メンバー等)が多くなればなるほど諸々が複雑化します。
その調整・整理がうまくできるとプロジェクトの成功率が上がるので、そういう人材も高評価でしょう。
(この辺りの経験や実績が豊富で自信のある方がいれば、是非ともうちの会社に来て欲しいくらいです)
データサイエンティストなどは専門性の高い職業のような印象があるかと思いますが、高く評価される方は専門性よりも実績が認められているのだろうと思います。
データアナリストもその点は同様で、どれだけ実績を上げたか(同等の実績を上げられるとみなされるか)が評価軸とされますし、そうあるべきでしょう。
ということで、データアナリストのキャリアアップ(社内)のちょっとした参考にでもなれば幸いです。
※一応ですが、今回の話はあくまで事業会社のデータアナリストを対象とした社内におけるキャリアです
※また途中でジョブチェンジすることも対象外です(データアナリストを続ける上でのキャリアップです)
前回の記事の続きです。
まだ読んでない方はそちらから読んでみてね。
まずは改めて前回扱った問題を掲載します。
(問)
頌子さんは、紙飛行機の飛距離を競う大会で使用するために紙飛行機A、Bを作りました。
大会では紙飛行機を1回だけ飛ばします。
下の表は、どちらの紙飛行機を大会で使用するか決めるため、それぞれ20回ずつ飛ばした結果を表しています。
それぞれの飛距離の平均を求めたところ、平均は等しくなりました。
あなたなら頌子さんにA、Bどちらの紙飛行機をすすめますか。
どちらを選んでも構いませんが、2つの表を比較して、選んだ理由を数を用いて具体的に答えなさい。
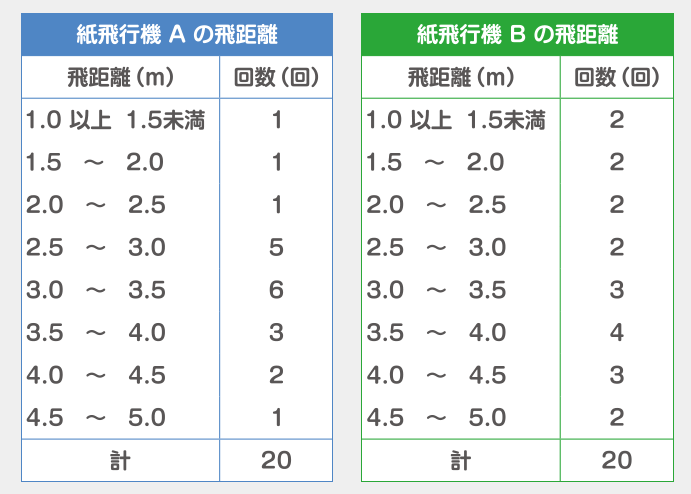
2024年09月 頌栄女子学院中学校【算数】 | 日能研 シカクいアタマをマルくする。
問題文を読むといくつかの前提条件が書かれていますが、ちょっと足りない気がします。
頌子さんは紙飛行機の飛距離を競う大会に出るようですが、そこで優勝したいと思っているのか、上位に入りたいと思っているのか、下位でなければ良いと思っているのか、目的が不明です。
仮に目的は大会で優勝すること(参加者の中で一番遠くに飛ばすこと)としましょう。
その場合、他の参加者の紙飛行機はどれくらいの飛距離を出すのかは非常に気になります。
例えば参加者全体の優勝ラインがもしも10m以上であるならば、AもBも最大で5mしか飛ばないと思われるので、そもそも頒子さんはAとBのどちらを選ぼうと優勝はほぼ無理でしょう。
他者の紙飛行機の飛距離情報がが不明であれば、優勝を目指せるかどうかも判断できません。
なので、紙飛行機はどの参加者もAまたはBと同性能のものしか使えないという前提のもと考えることにしてみましょう。
ちなみにこうした「目的」や「前提」がないとそれに沿った適切なデータ分析はできず、当てずっぽうでまぐれ当たり狙いのデータ分析になってしまうので、まずはそれらを整える必要があります。
さてこの場合、みなさんならどのような分析をして、頌子さんにどちらの紙飛行機を勧めるでしょうか。
(シンキングタイム)
。。。
。。
。
では私の解答を紹介してみます。
自分ならBを勧めます。
優勝となる最長距離がもし3.5~5mの場合、その距離まで飛ぶ確率はBの方が高いからです。(Aは30%、Bは45%)
もちろん最長距離が3.5~5mになるとは限りませんが、そうなる確率も一応計算してみましょう。
もし、AとBひとりずつしか参加者がいなかった場合、最長の飛距離が3.5m以上になる確率は61.5%です。(30% + 70% x 45%)
一方最長距離が3.5m未満になる確率は38.5%です。
なお問題文に参加者の人数が書かれていないのですが、大会なので参加者はおそらくもっとたくさんいると思われます。
もしAとBそれぞれ5人ずつ参加するとなると、最長の飛距離が3.5m未満になる確率は1%未満とさらに低くなります。(38.5%の5乗)
ということで、優勝距離が3.5m以上になる可能性は非常に高いと思われます。
なお、目的が優勝すること(参加者の中で一番遠くに飛ばすこと)ではなかったり、前提条件も異なっていれば、当然分析結果や結論も違ってくる可能性はあります。
(例えば最下位にはなりたくないという目的であれば、お勧めすべきはAだったりします。)
データ分析ではまず目的を明確にすることや、前提条件を整え課題を構造化して捉えることが大事と言われるのは、こうした理由もあったりします。
ということで、きちんと目的を踏まえた上でそれを叶えるために客観的で納得性のある根拠を提示するような回答でないと、〇にはできないだろうと思われます。
データを見てから考える癖がついてしまうと、「目的や前提は何か」ということに意識が向かなくなる可能性が高くなります。
目的や前提条件が不明な状態であれば、自らそれを調査したり、確認するといったことが必要です。
データはFACTを教えてくれますが、活用方法は教えてくれません。
若い人たちには、データを処理したり、読み解くといったスキルだけではなく、活用するためのスキルも学んでほしいものですね。
